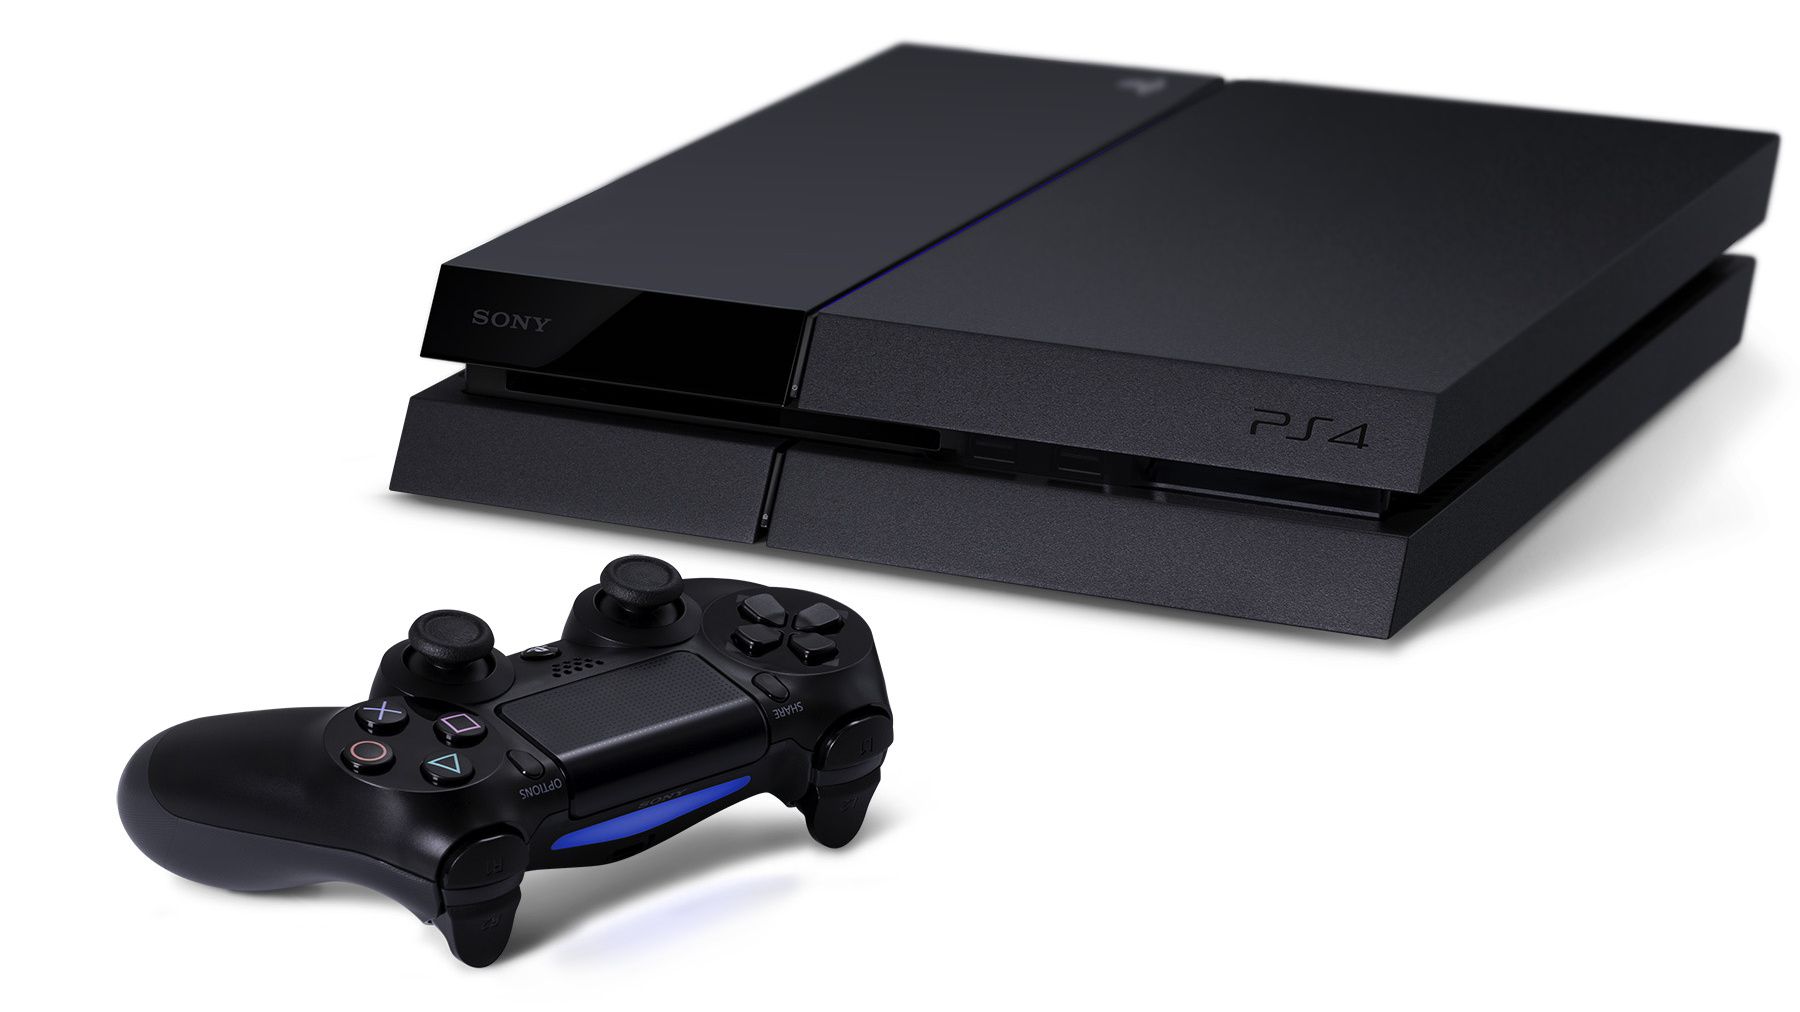
Proyek sumber terbuka Garlic LLM memungkinkan konsol PlayStation 4 yang sudah di-jailbreak menjalankan model bahasa Qwen3.5-9B dengan 9 miliar parameter secara offline. Aplikasi buatan pengembang Leonardo Alegría ini berkomunikasi langsung dengan GPU PS4 yang dirilis pada 2013. Model diperkecil menjadi sekitar 4,5GiB agar muat di memori konsol, lalu berjalan pada 31 hingga 39 token per detik.
Berjalan di GoldHEN dan dipasang dari Hugging Face
Garlic LLM dinamai mengikuti memori yang dibaca langsung oleh GPU; memori saudaranya dikenal sebagai “Onion”. Proyek ini membutuhkan PS4 yang menjalankan GoldHEN, pendukung homebrew untuk konsol yang dieksploitasi. Berkasnya berupa unduhan tunggal gratis berukuran 5,66 GB di Hugging Face dan dapat dipasang melalui PS4 Package Installer. Dibutuhkan ruang kosong sekitar 6 GB, atau 12 GB jika paket lebih dulu disalin ke disk internal konsol.
Pengembang menguji Garlic LLM pada PS4 dasar/Slim dengan firmware 11.52. Selain percakapan teks, aplikasi ini mendukung percakapan suara dengan balasan lisan dalam tujuh bahasa melalui model ucapan Chatterbox, sementara model obrolan berjalan sekitar 22 token per detik. Tombol pengontrol yang ditahan dapat mengaktifkan dikte menggunakan model ucapan-ke-teks Parakeet TDT 0.6B v3 dari Nvidia, yang mendukung 25 bahasa Eropa. Model Parakeet juga mendukung aplikasi transkripsi dan dikte lokal seperti Meetily dan Hex.
Cara model 9 miliar parameter muat di memori 8 GB
Model utama adalah Qwen3.5-9B berbobot terbuka dari Alibaba. Kecepatan 31 hingga 39 token per detik dalam obrolan teks disebut, tetapi metode dan pengujiannya tidak dirinci. Pertanyaan yang muncul adalah bagaimana model 9 miliar parameter bisa masuk ke memori PS4 sebesar 8 GB yang dipakai bersama CPU dan GPU. Dengan 8 bit per bobot, dibutuhkan satu byte per parameter atau setidaknya 9 GB, dan biasanya lebih besar dari itu secara keseluruhan.
Jawabannya sebagian ada pada bobot 4-bit (“Q4”) yang memakan separuh ruang, meski bobot 3-bit (“Q3”) sekitar 3,5 bit dengan skala dipakai untuk dua matriks terbesar di setiap lapisan. Kombinasi ini menghasilkan sekitar 4,5GiB, dibandingkan sekitar 4,9GiB jika seluruhnya 4-bit. Cache atensi atau KV juga berukuran 4-bit, sehingga konteks 16K token bisa muat, jauh lebih kecil dari konteks asli model sebesar 256K. Model dikte Parakeet menambah 0,33GiB, sedangkan model suara Chatterbox 0,29GiB dan 0,09GiB, dengan total 5,23GiB atau 5,62 GB, sangat dekat dengan ukuran paket 5,66 GB.
Tanpa llama.cpp, kernel OpenCL langsung ke GPU
Pendekatan Garlic LLM berbeda dari PS5LM, fork terdekat yang menjalankan llama.cpp sebagai aplikasi asli di PS5 dan menjangkau GPU AMD konsol melalui PS5_Vulkan, port driver RADV. llama.cpp adalah program sumber terbuka yang banyak digunakan untuk menjalankan model bahasa secara lokal, sedangkan RADV adalah driver sumber terbuka yang memungkinkan GPU AMD menjalankan Vulkan, API grafis dan komputasi. Di PS4 tidak ada lapisan driver untuk homebrew; Garlic LLM tidak memakai llama.cpp, port Vulkan, atau lapisan semacam itu.
Operasi model, seperti perkalian matriks pada bobot 4-bit, dijalankan sebagai kernel komputasi yang ditulis dalam OpenCL C dan dikompilasi dengan LLVM untuk arsitektur Graphics Core Next (GCN) AMD. Bobot disimpan di memori “Garlic”, sementara sisi CPU dalam bahasa C biasa menangani tokenizer, antarmuka, rendering teks, dan audio. Pipeline berjalan dari prompt ke tokenizer CPU, lalu untuk setiap token dibuat buffer perintah PM4—perintah tingkat rendah yang biasanya dihasilkan driver grafis, tetapi dalam hal ini dibuat sendiri oleh aplikasi—dan kernel GCN, sebelum token ditampilkan atau diucapkan. Seluruhnya dibangun dengan toolchain sumber terbuka OpenOrbis PS4.
MTP dan kecepatan hingga 43 token per detik
Qwen3.5 memiliki kepala prediksi multi-token (MTP). Garlic LLM memanfaatkannya untuk menyusun hingga dua token ke depan dengan verifikasi model penuh. Pengaturan ini sesuai dengan tujuan pelatihan model, dan instruksi vLLM pada kartu model Alibaba menggunakan dua token spekulatif. Proyek ini menyoroti kecepatan obrolan pada perangkat keras tahun 2013. Dengan pengaturan ini, keluaran juga bisa lebih cepat, hingga 43 token per detik.
Suhu default atau variabilitas model adalah 0,7. Alibaba merekomendasikan 0,7 untuk tugas umum tanpa mode berpikir dan 1,0 saat mode itu diaktifkan, meskipun video demo memakai 0 agar jawaban dapat diprediksi. Pada 35 token per detik, di tengah rentang kinerja yang dilaporkan, jawaban 300 token membutuhkan waktu kurang dari sembilan detik. Sebagai perbandingan, PS5 menjalankan Qwen3.8-27B yang tiga kali lebih besar dengan kecepatan sekitar 20 token per detik, sedangkan Gemma 4 E4B dan Llama 3.2 3B yang lebih kecil masing-masing mencapai 61 dan 124 token per detik dan berpotensi lebih cepat.
PS4 Pro dan PS5
PS4 Pro disebut “belum diuji”, tetapi pengembang meminta laporan dari pengguna melalui GitHub. PS5 tidak didukung karena aplikasi ini ditulis khusus untuk GPU dan perangkat lunak sistem PS4. Aplikasi ini sendiri tidak mengandung eksploitasi, tetapi GoldHEN dipasang dengan risiko yang ditanggung pengguna sendiri.
About the Author